AI可視性(シェア・オブ・ボイス)の測り方|LLMO効果測定の5軸
「LLMO対策を
この
結論:測るべきは「AI回答内でのシェア・オブ・ボイス」
先に
そして
なぜSEOのKPIが通用しないのか
従来の
- 順位と
いう — AIは概念が 違う 10本の 青いリンクを 並べるのではなく、 1つの 答えを 合成します。 そこに 「1位」は なく、 あるのは 「答えの 中で 言及されたか、 どんな 文脈で 推奨されたか」です。 - クリックが
発生しない — ユーザーはAIの 回答内で 意思決定を 終える ことが 多く、 サイトに 来る 前に 検討が 済みます (ゼロクリック)。 CTRや 流入数では、 この 「見えない 影響」を 捉えられません。 - エンジンごとに
答えが — ChatGPT・Claude・Gemini・Google AI Overviews は、違う 同じ 質問でも 異なる 答えを 返します。 単一の 順位表は 存在しません。
だからこそ、
AI可視性を測る5つの軸
私たちは、
① 可視性(シェア・オブ・ボイス)
何を
② 順位
何を
③ センチメント
何を
④ 競合
何を
⑤ 引用元(ソース)
何を
この
プロンプトパネルの作り方
測定の
- トピック × 購買者の
質問で —設計する 「カテゴリの おすすめは?」 「自社の 評判は?」 「競合との 違いは?」 「〈課題〉を 解決するには?」など、 顧客が 実際に AIへ 投げる 質問を 洗い 出します。 - 数は
50〜100プロンプトを — 少な目安に する すぎると、 たまたまの 1回に 振り回されます。 ある 程度の 数が あって 初めて 「割合」に 意味が 出ます。 - エンジン別に、
定期的に — 各エンジンは測る 同じ 質問でも 異なる 答えを 返します。 だから 複数エンジンで、 週次など 一定周期で 測ります。 - 1回の
チェックで — さらに複数回サンプリングする 見落と されがちなのが、 AIは 同じ エンジン・ 同じ 質問でも、 実行の たびに 答えが 変わると いう 点です。 1回の チェックに つき同じ プロンプトを 3〜10回繰り返して 平均を 取ると、 「たまたまの その 1回」に 振り回されない、 再現性の ある 数字に なります。 エンジン間の 違い (横の ばら つき)だけでなく、 同一エンジン内の 実行ごとの 揺れ (縦の ばら つき)まで 均すのが、 客観的な AI可視性の 条件です。 単発の 1回だけを 切り 取って 報告する 簡易的な 計測では、 この 揺れを 均せません。
この
月次レポートに何が載っているべきか
良い
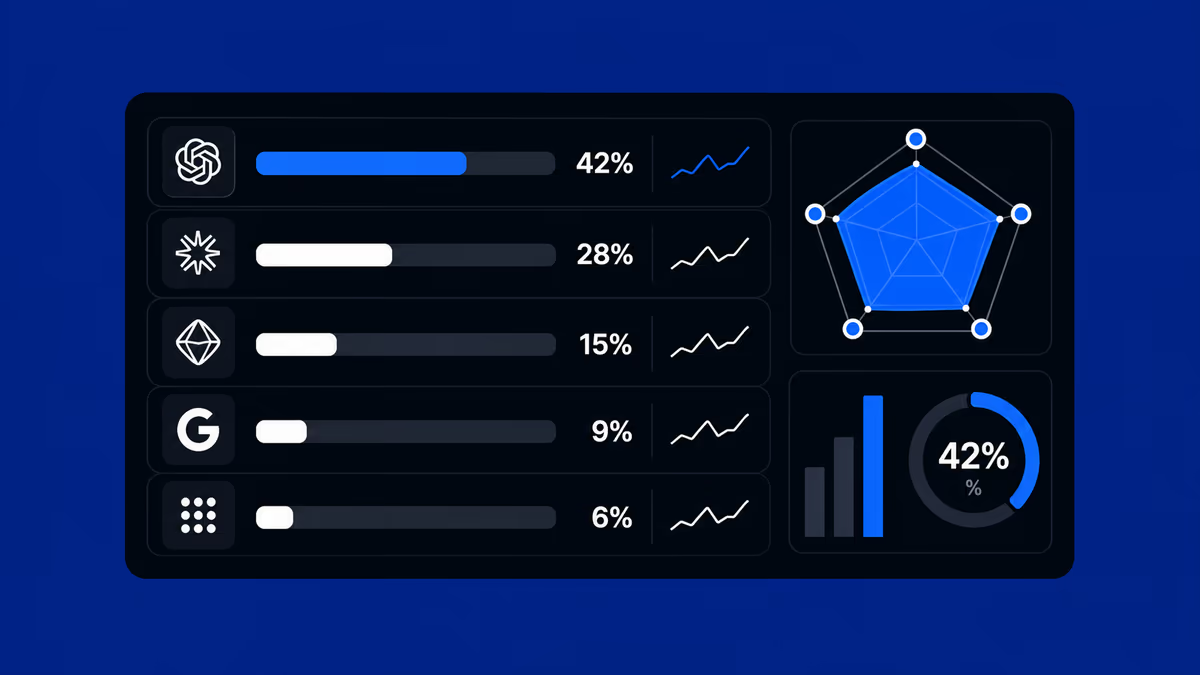
| エンジン | 可視性 | センチメント | 順位 |
|---|---|---|---|
| 全体 | 67% | +0.6 | #2.3 |
| ChatGPT | 100% | +0.8 | #1.7 |
| Claude | 67% | +0.6 | #2.3 |
| Gemini | 33% | +0.4 | #3.3 |
| AI Overviews | 67% | +0.5 | #2.0 |
※データは
この
計測
私たちの
な
測定でやりがちな失敗
最後に、
- 単発プロンプトの
逸話で —判断しない 「試しに 1回聞いたら 出た /出なかった」は 測定ではありません。 エンジンの 回答は 揺れるので、 割合で 見る必要が あります。 - 都合の
いいスクリーンショットだけを — 出てきた集めない 場面だけを 切り取ると、 実態を 見誤ります。 固定パネルで、 出た 回も 出なかった回も 等しく 数えます。 - 施策の
たびに — AIへの測らない 反映には 時間が かかります。 変更の たびに 測ると、 ノイズを 成果と 誤読します。 月次など 一定周期で まとめて 見ましょう。
測定は、
よくあるご質問
- AI可視性とは
何ですか? -
固定した
質問群 (プロンプトパネル)に 対して、 AIの 答えの 中で 自社が どれだけ言及・ 推奨されるかを 示す指標です。 中心と なる 数値が 「シェア・オブ・ ボイス (推奨シェア)」 ——競合と 比べて、 AIの 回答内で 自社が どれだけの 割合を 占めているか、です。 検索順位に 代わる、 AI検索時代の 北極星指標と 考えてください。 - どの
くらいの 頻度で 測るべきですか? -
週次での
計測、 月次での レビューが 実務的な 目安です。 AIの 回答は 実行の たびに 揺れる ため、 1回の チェックで 同じ プロンプトを 複数回 (目安3〜10回) 実行して 平均し、 週次で 数を 取ってならすと 精度が 上がります。 一方で 施策の 反映には 時間が かかる (早い面で 1〜3ヶ月、 推奨シェアの 本格的な 変化で 3〜6ヶ月) ため、 成果の 判断は 月次以上の 周期で 見るのが 適切です。 施策の たびに 一喜 一憂しない ことが 大切です。 - 無料で
AI可視性を 測る 方法は ありますか? -
あります。
ChatGPTや Geminiに、 自社と 競合に ついて 複数の 質問を 投げ、 言及の 有無・順位・トーン・引用元を 手で 記録すれば、 無料でも 現在地は つかめます (自社セルフチェックの 手順は )。こちら 機械可読性の 側は、 PageSpeed Insightsが 無料で 採点してくれます (Agentic Browsingの 解説 )。ただし 手動は、 プロンプト数を 増やすと 手間が 跳ね上がり、 エンジンごとの 揺れを ならすのも 困難です。 数十プロンプト×複数エンジン×継続、と いう 規模に なると、 計測プラットフォームか 外部支援が 現実的に なります。 - ベンダーの
レポートは 何を 基準に 評価すればいいですか? -
「①エンジン別に
出しているか、 ②名前の ある 競合と 比較しているか、 ③単発ではなく 継続計測か、 ④数字に 『な ぜ動いたか』の 解釈が 添えられているか」の 4点です。 これらが 揃わず、 きれいな スクリーンショットが 並ぶだけの レポートは、 成果ではなく 作業の 報告書である 可能性が あります。 判断軸はLLMO対策会社の 比較記事 でも解説しています。